中国人工智能开源的大规模模型在词元调用量的数据方面, 持续经历了长达27个星期的时间超过了美国的水平, 这一具体的统计结果在乌镇举行的高峰会议上, 导致了全球范围内的热烈讨论与反响情况, 并且展现出开放性的生态系统是本届会议之中最为关键的讨论议题。
峰会开幕与开源专区亮相
千年古镇再聚全球科技力量
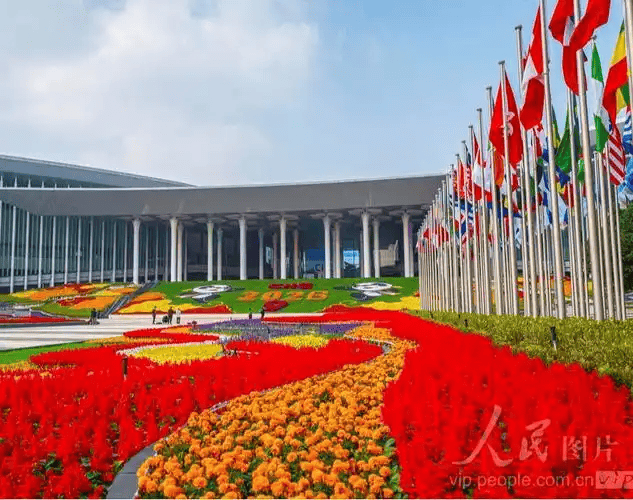
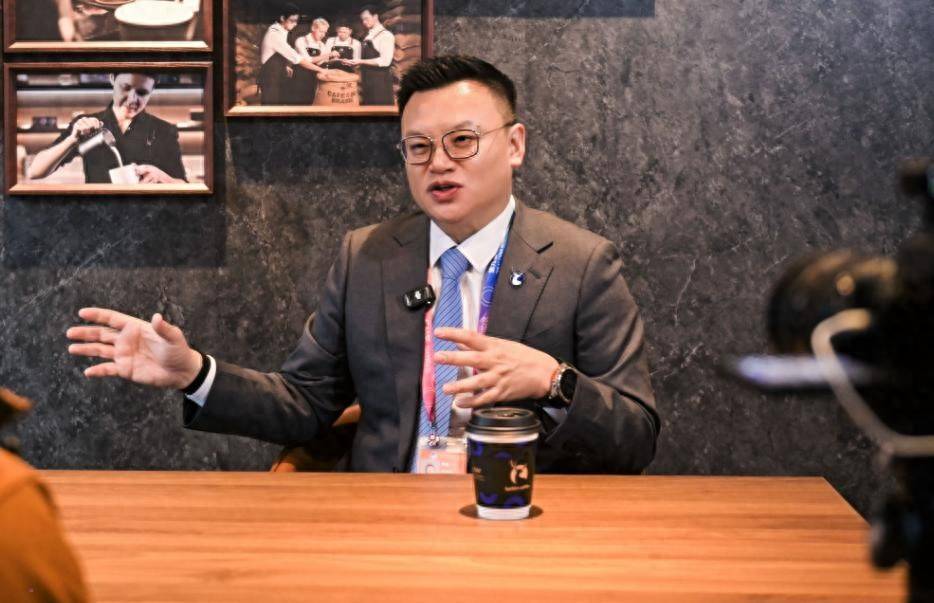
11月3日的时候, 2026年世界互联网大会乌镇峰会已经在浙江乌镇正式开幕了, 与此同时亮相的开源主题生态体验馆, 也吸引大批的参会者驻足体验了。
峰会会对中国大模型在工业制造、医疗健康、公共服务这些场景下面的最新落地成果, 进行集中的展示。现场会安排持续整天的互动演示环节。
调用量数据印证全球热度
中国模型占据前五中四席
根据OpenRouter平台公布的统计数据, 在从10月26日到11月1日这一周内, 中国大模型的Token调用数量已经连续保持了27周排在首位, 并且超越了美国, 这个领先的优势情况还在不断加大幅度。

在同时段全球Token一周的总调用量排名前五名的那些中间, 中国的模型占了四处地方。在这其中的时候, DeepSeek这个凭借最大的调用量排在了全球的榜首位置上面。
海外企业加速部署中国模型
硅谷与德国中小企业成主力
全球移动通信系统协会的董事长这个人名叫做洪曜庄的人, 在开峰会的那个时候表示说, 中国那边的大语言模型以及小语言模型这些个东西, 发展的进度是非常明显的, 而且大多数的这种成果都是在一个叫作开源的平台上面搞出来的。
德国明斯特大学的教授霍尔茨纳格尔讲了一句话, 他说的是现在这个实际情况。这个情况就是美国硅谷那边的好几家公司, 还有德国将近一半数量的中小企业, 都已经把中国的开源人工智能大模型放到了实际的应用里去了。
开源降低全球创新成本
非洲多语言模型成典型案例
阿里巴巴方面的人士是蔡崇信, 他强调了这样一个事情, 那就是说开源这个东西可以大幅地降低中小企业在进行研发时候所要付出的成本, 它能够让那些来自新兴经济体的开发者更快地基于现有的开源模型创建出符合本国需要的应用, 并且这里的提到的技术方向是与人工智能相关的, 也就是常说的AI。
在乌干达, 有一个非营利组织, 他们用了千问模型作为基础来开发那个本地语言模型, 目前它已经覆盖了68种非洲语言了, 这样做是为了让那里的用户能够打破语言障碍, 从而接触到人工智能技术。
打破技术垄断与封闭壁垒
社区智慧解决长尾难题
千问项目的负责人刘大一恒直言不讳地指出, 如果没有开放源码, 人工智能的核心技术就只会被少量的企业和少数人所掌握。在这样的情况下, 创新的空间会变得非常有限。
开源模式能够助力那些资源相对匮乏的学者与学生群体, 让他们以较低的成本门槛参与到创新活动中去, 此外, 对于一些头部企业不太重视的、比如小语种适配这类长尾需求问题, 也可以借助于社区里的集体力量来得到解决。
全球共识呼唤开放创新
小院高墙难以持续
与会的那帮人, 大家都普遍地觉得一个事情。如果把这个AI技术给锁在那个封闭的体系里面。那么创新的那个火苗子就很难大面积地烧起来。这种情况到最后的话, 肯定会阻碍全球科技进步。也会阻碍让科技应用能够广泛普及这件事情发生。
蔡崇信说, 在过去这一年里, 全球人工智能的应用场景向很多领域伸出去了, 中国科技企业那边的开源下载量数据、还有衍生出来的模型数量等指标, 一直都保持在世界领先的位置。
你现在可以聊聊, 你觉得那个所谓的AI开源这种模式, 到底能不能让那些处于发展中的国家, 真正在技术发展的前沿地带追上来, 如果评论区里的讨论让你觉得有一定的启发性作用的话, 那么就不要忘记去点击一下点赞选项, 同时还要进行分享操作。